 株式市場調査レポート
- 論文の「非合理性ファクター」を予測モデルに足しても、予測精度(IC)は0.0259から0.0260とほぼ変わらなかった。差は偶然のぶれで説明がつく(p=0.998)
- 予測の上位20銘柄を買い下位20銘柄を売る戦略は、コスト前のシャープレシオが1.01から2.34に上がった。ただし片道0.05%の取引コストを引くと、どちらのモデルも年率でマイナスになり、毎日入れ替える運用ではそのまま使えない
- 論文が米国・中国で報告したICの改善は日本株では再現できなかった。ファクターは予測を当てる力より、予測のぶれを抑える働きをしていた。最大ドローダウンが54.5%から28.4%に縮んだのがその表れだ
株価は理屈どおりに動いているのか。効率的市場仮説(株価はその時点で手に入る情報を正しく映している、という考え方)は金融理論の土台だが、実際に売買していると、業績にも金利にも説明のつかない値動きにしょっちゅう出くわす。2025年には、データ科学の国際会議KDDでこの問題を扱った論文が採択された。Learning Universal Multi-level Market Irrationality Factors to Improve Stock Return Forecasting(Yang et al., KDD 2025)で、提案手法の略称はUMIという。この論文は、その説明のつかない部分を数値にして予測モデルに足すと、株価予測が良くなると主張している。
この記事では、論文の手法を日本株約330銘柄・13年分の日足で試した。予測精度はほとんど変わらなかった。売買の成績は良くなったが、取引コストを引くと利益は残らなかった。
1. 論文の概要と仮説
論文の考え方は「株価には理屈で説明できない動きがあり、その大きさを測って予測モデルに入れれば当たりやすくなる」というものだ。説明できない動きを、論文は2つの層で測る。
銘柄レベルの非合理性: 仲間の銘柄から離れた分
個別の株価は、関係の深い銘柄と足並みをそろえて動くことが多い。半導体の株が全体に上がっている日に、業績に問題のない1社だけが下がっていれば、その差は理屈で説明できないずれと見なせる。論文はこのずれを測るために、ほかの銘柄の価格に重みを付けて合成した「本来あるべき株価」をニューラルネットワークで学習する。重みの決め方は、実際の株価との差が長い目で見てゼロに戻る関係(共和分)になること。この差が銘柄レベルの非合理性で、差が大きいほどいずれ元に戻る(平均への回帰)と考え、その戻りを予測の材料に使う。
市場レベルの非合理性: 全銘柄が同じ方向にそろう度合い
もう1つは市場全体の話だ。ふだんは各銘柄がそれぞれの業績や材料で動くので、全銘柄が同じ方向にそろうことは少ない。パニックの売りや熱狂の買いが起きると、多くの銘柄が一斉に同じ方向へ動く。論文は、一定の幅を超えて動いた銘柄の数が決めた数を超えた日を市場レベルの非合理な状態と定義する。その状態を表す数値を市場全体のデータから学習して、予測モデルの入力に足す。
論文が報告した改善
論文は、米国の8,993銘柄と中国の5,148銘柄で検証している。既存の予測モデル3つに2つの非合理性ファクターを足すと、予測精度(IC。後述)は4〜11%上がった。予測の上位を買って下位を売るロングショート戦略のシャープレシオ(リスク1単位あたりの利益。1.0以上で優秀とされる)も19〜41%改善したと報告している。論文が提案する予測モデル自体は、最も成績の良い既存モデルと比べてICが6〜10%、シャープレシオが39〜47%高かった。
2. データと検証手法
論文の手法を日本株で再現するため、次のデータと条件で検証した。
| 項目 | 内容 |
|---|---|
| 対象銘柄 | 手元の株価データベースに日足がそろう352銘柄のうち、業種の対応が取れる345銘柄(東証プライム市場が中心)。指標の計算に必要な日数がそろわない期間を除くと、テスト期間は1日あたり平均318銘柄 |
| 対象期間 | 2013年1月〜2026年4月(約13年) |
| データ分割 | 訓練: 2013〜2019年 / 検証: 2020〜2021年 / テスト: 2022年1月〜2026年4月 |
| 入力 | 始値・高値・安値・終値・出来高から作った10個の指標(1日〜20日のリターン、5日・20日の移動平均からの乖離、出来高の増減、値幅、20日の変動率、RSI)を過去20営業日分 |
| 追加ファクター | 銘柄レベルの非合理性(業種内の乖離、2項目)+ 市場レベルの非合理性(銘柄間の同期度、2項目) |
| 予測対象 | 翌営業日のリターン |
| モデル | LSTM(時系列の学習に向いたニューラルネットワークの一種。2層、隠れ層64)。論文のモデルはTransformerとグラフ注意を組み合わせた独自の構成で、今回は簡単なLSTMで代用した |
| 業種分類 | 東証33業種(対象銘柄に含まれるのは30業種) |
| 評価指標 | IC(予測と実際のリターンの相関)、RankIC(順位の相関)、ロングショート戦略のリターンとシャープレシオ |
株価データは、自分で日次収集しているPostgreSQLの日本株データベースから取得した。2026年4月22日のノートブック実行時点で352銘柄・1,043,611行(2012年1月〜2026年4月)あり、ここから業種の対応が取れない銘柄と指標の欠損期間を除いて使っている。
3つのモデルの比較
どのファクターが結果を変えたのかを切り分けるため、ファクターを1つずつ足した3つのモデルを比べた。
- ベースライン: 価格と出来高から作った10個の指標だけを入力にするLSTM
- 銘柄レベルのみ: ベースラインに銘柄レベルの非合理性(業種内の乖離)だけを足したモデル
- 全ファクター: 銘柄レベルと市場レベルの両方を足した、論文のフルモデルに相当する構成
ファクターの計算の中心は、検証ノートブックの次のコードだ。同じ業種の平均リターン(自分自身は除いて計算する)に、その銘柄がどれだけ連動するかを過去60日で推定し、連動で説明できない残りを銘柄レベルの非合理性として特徴量に加えている。
# セクター平均リターン(自銘柄を除いた平均)
daily['sector_ret_loo'] = (daily['sector_sum'] - daily['ret_1d']) \
                          / (daily['sector_count'] - 1).clip(lower=1)

# 60日ローリングでセクター感応度betaを推定し、残差を非合理性とする
g['cov_60'] = g['ret_1d'].rolling(60).cov(g['sector_ret_loo'])
g['var_60'] = g['sector_ret_loo'].rolling(60).var()
g['beta_sector'] = (g['cov_60'] / g['var_60'].replace(0, np.nan)).clip(-3, 3)
g['stock_irr'] = g['ret_1d'] - g['beta_sector'] * g['sector_ret_loo']
g['stock_irr_abs_ma5'] = g['stock_irr'].abs().rolling(5).mean()評価指標の読み方
ICは、その日の全銘柄について「モデルの予測値」と「実際の翌日リターン」の相関係数を取った値で、テスト期間の1,031営業日の平均で比べる。RankICは値そのものではなく順位どうしの相関で、極端な値動きの影響を受けにくい。どちらも大きいほど予測が当たっている。実用上の目安として、運用の現場では日次のICが0.03〜0.05あれば使い物になり、0.05を超えれば良いほうとされることが多い。
データの前提条件と制約
今回の検証のデータと手法には次の制約がある。結果はこの前提のうえで読んでほしい。
- 銘柄数: 論文は米国8,993銘柄・中国5,148銘柄で検証しているが、今回は1日あたり約320銘柄。銘柄数が少ないと業種内の乖離の計算が不安定になりやすい
- 本来あるべき株価の作り方: 論文はほかの銘柄との関係をデータから学習するが、今回は東証33業種の平均で代用した。同じ業種でも動きが違う銘柄は多い
- 市場レベルの近似: 論文はニューラルネットワークで学習するが、今回はTOPIXと同じ方向に動いた銘柄の割合と、銘柄間のリターンのばらつきを、過去60日で標準化して組み合わせた値で代用した
- 生存者バイアス: 検証期間中に上場廃止になった銘柄は含まれていない
- 戦略の設定と取引コスト: 論文は上位・下位それぞれ全銘柄の10%を売買し、売買した銘柄1つにつき0.1%のコストを引く。今回は上位・下位各20銘柄で、毎日全銘柄を入れ替える前提で片道0.05%(1日あたり0.1%)を引いた成績も出した
- 過学習の余地: LSTMの層数や学習率は検証データで選んだ。テスト期間の2022〜2026年は、日銀の政策転換や円安が進んだ時期でもある
3. 3モデルともほぼ同じだった予測精度
テスト期間(2022年1月〜2026年4月、1,031営業日)の平均は次のとおり。
| モデル | 平均IC | 平均RankIC | ICがプラスの日 |
|---|---|---|---|
| ベースライン | 0.0259 | -0.0085 | 55.9% |
| 銘柄レベルのみ | 0.0316 | -0.0008 | 57.9% |
| 全ファクター | 0.0260 | -0.0006 | 55.1% |
平均ICは3モデルとも0.026〜0.032に収まり、差はごくわずかだった。銘柄レベルのファクターだけを足したモデルが0.0316でいちばん高く、市場レベルも足した全ファクターのモデルは0.0260と、ベースラインと同じ水準に戻っている。市場レベルのファクターを足したことで、かえって雑音が増えたのかもしれない。
RankICは3モデルともゼロ付近か、ごく小さいマイナスだった。ICがプラスでRankICがゼロ付近という組み合わせは、上がるか下がるかの大まかな方向は少し当てられているが、どの銘柄がほかより良いかという順位はほとんど当てられていない状態を表す。
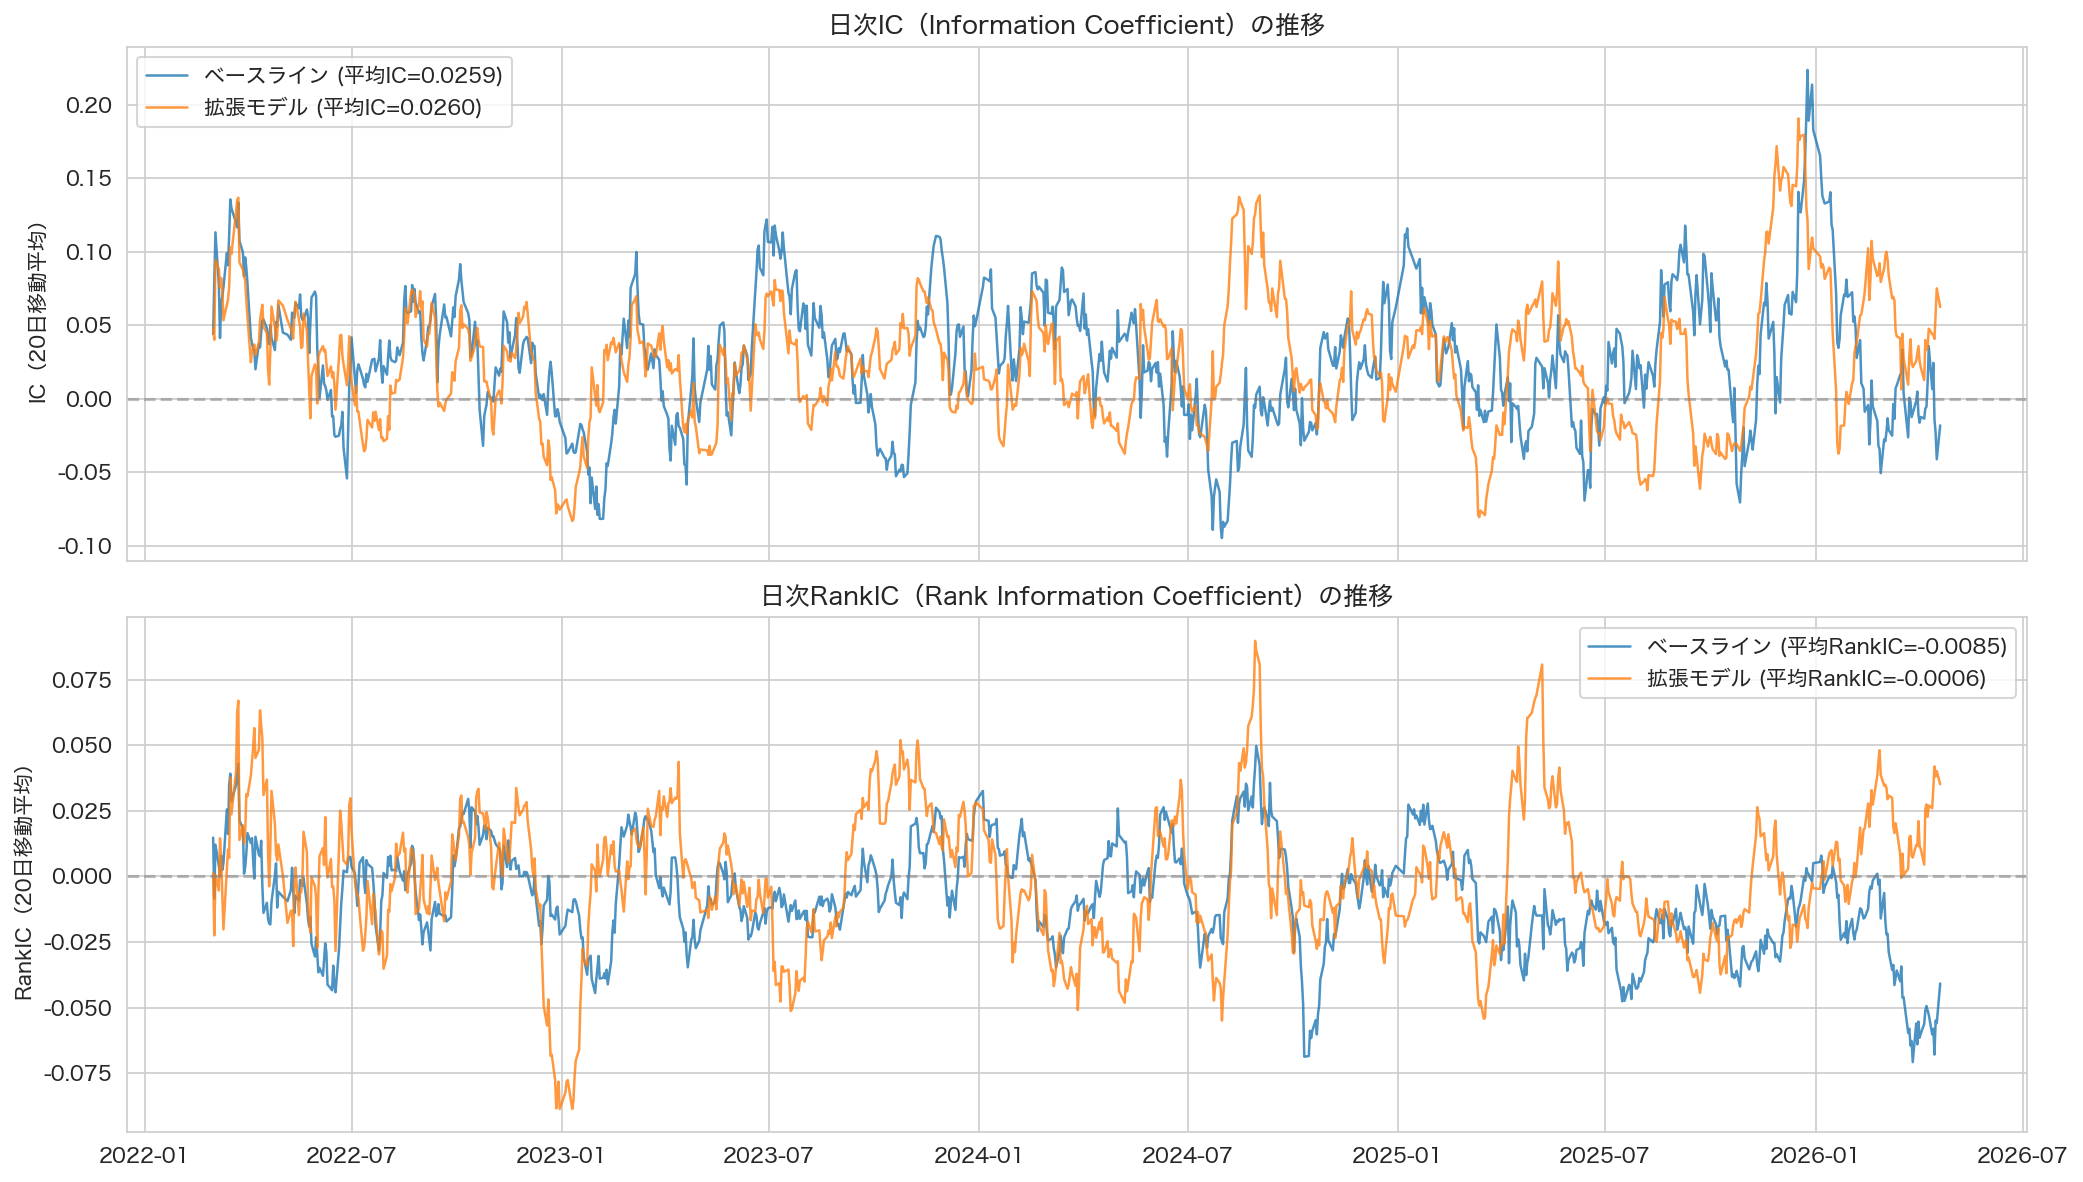
図1: テスト期間(2022年1月〜2026年4月)の日次ICの20日移動平均。青がベースライン、オレンジが全ファクターのモデル。2本の線はほぼ重なって上下しており、ファクターを足したことによる一貫した改善は見えない。
統計検定の結果
ICの改善が偶然のぶれで説明できるかどうかを、日ごとのICの差についてt検定(差の平均がゼロと言えるかを調べる検定)で確かめた。
ICの差はp値が0.998で、改善したとは言えない。RankICの差は+0.0079でp値は0.057。5%の基準にわずかに届かないので、順位の予測が良くなった可能性は捨てきれないが、効果があったと言い切れる水準でもない。
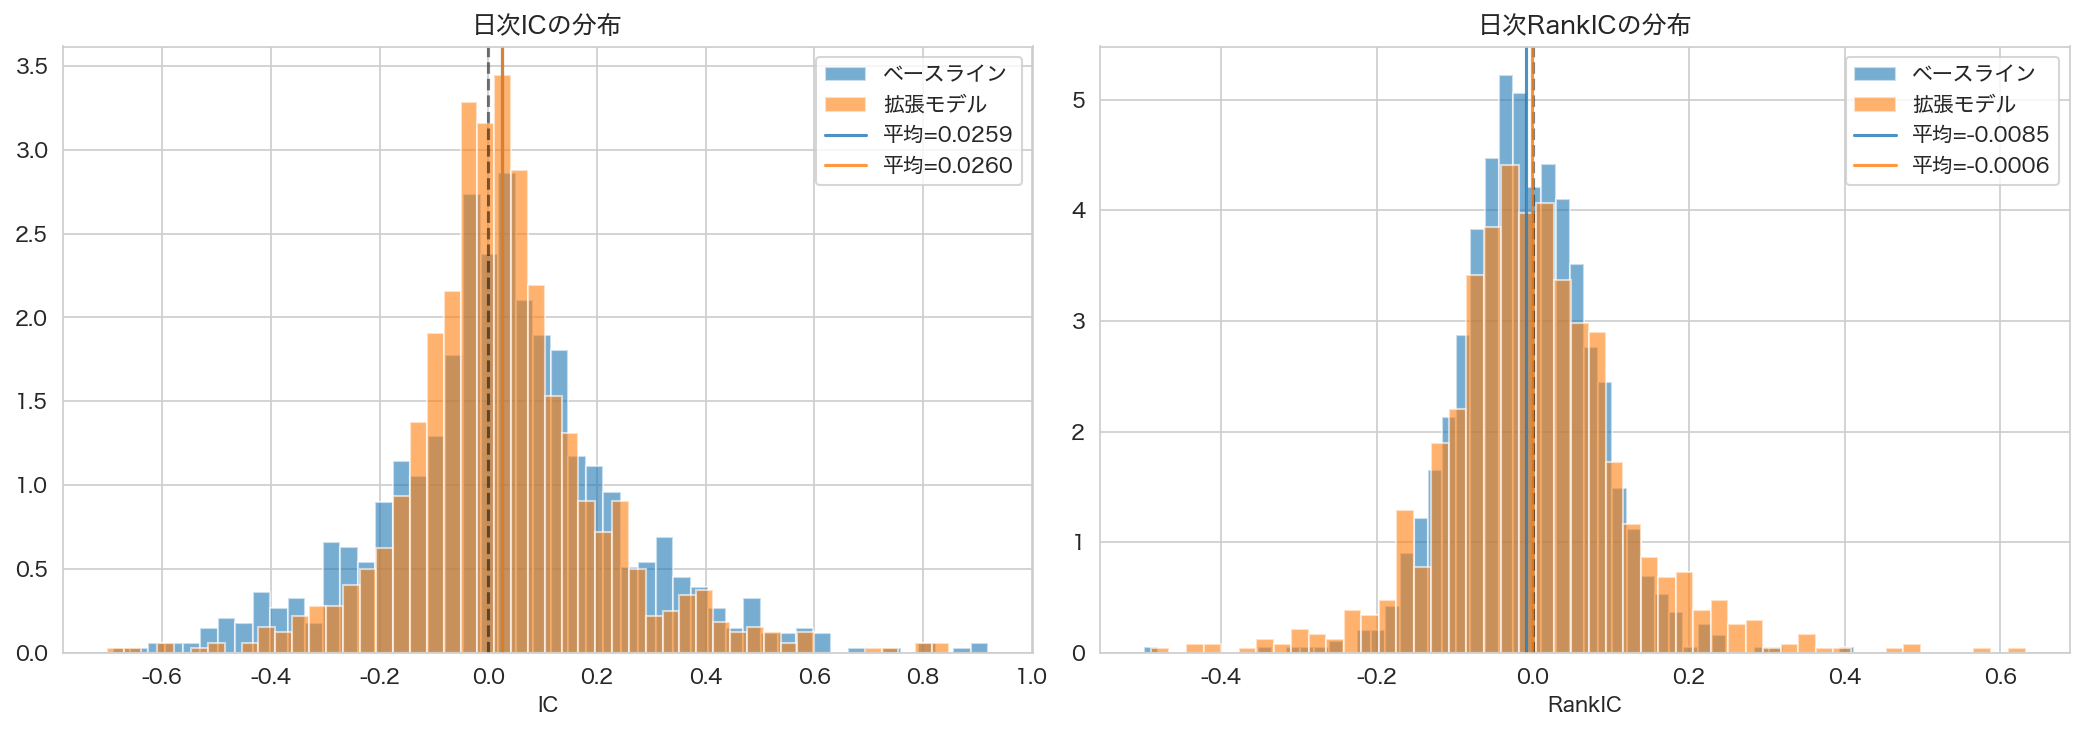
図2: 日次ICとRankICの分布。ベースライン(青)と全ファクターのモデル(オレンジ)の形はほぼ同じで、分布のずれは見えない。どちらも中心はゼロ付近にあり、ICがプラスの日がやや多い。
4. コスト前だけ良くなったロングショート戦略
予測精度が変わらなくても、売買の成績は変わることがある。各モデルの予測値で毎日、上位20銘柄を買い(ロング)、下位20銘柄を売る(ショート)戦略を組み、テスト期間で成績を比べた。
| 指標 | ベースライン | 全ファクター | 変化 |
|---|---|---|---|
| 年率リターン(コスト前) | 10.4% | 25.8% | +15.4pt |
| シャープレシオ(コスト前) | 1.01 | 2.34 | +1.33 |
| 年率リターン(コスト後、片道0.05%) | -13.6% | -1.5% | +12.1pt |
| 最大ドローダウン(コスト後) | -54.5% | -28.4% | 改善 |
| 日ごとの勝率 | 46.4% | 48.6% | +2.2pt |
コスト前の数字は良い。全ファクターのモデルはシャープレシオが2.34で、ベースラインの1.01の2倍以上になり、年率リターンも10.4%から25.8%に伸びた。最大ドローダウン(累積リターンが直前の高値からどれだけ落ちたかの最大値)も54.5%から28.4%に縮んでいる。
取引コストを入れると景色が変わる。毎日40銘柄を全部入れ替える前提で1日0.1%を引くと、ベースラインは年率-13.6%、全ファクターのモデルも-1.5%と、どちらもマイナスに落ちた。1日あたりの平均の利益が0.1%に届かないので、手数料を払うだけで利益が消える。
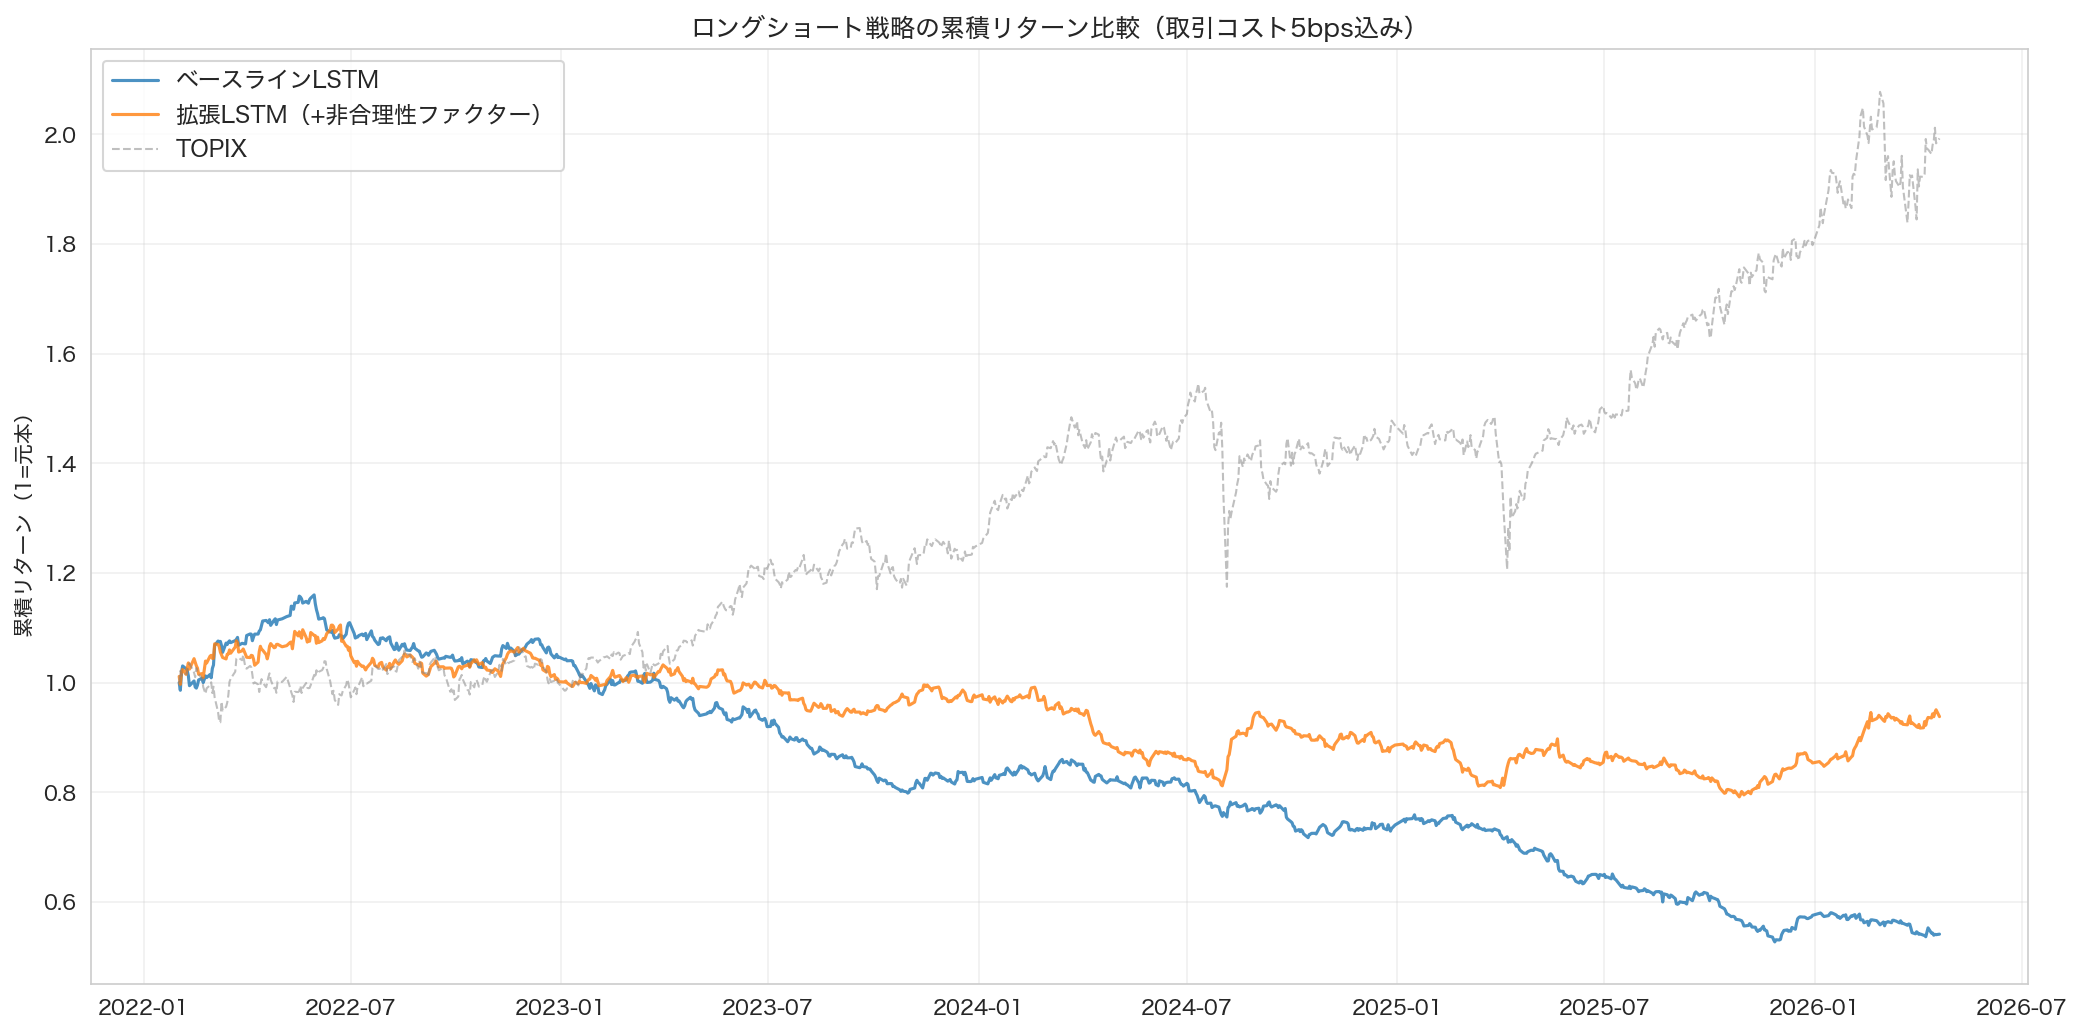
図3: 取引コスト(片道0.05%)を引いた後の累積リターン。ベースライン(青)は元本の0.55倍まで減り、全ファクターのモデル(オレンジ)も0.94倍と元本を割った。灰色の破線は同じ期間のTOPIXで、約2倍になっている。
ICは横ばいなのにシャープレシオが上がった理由
予測精度(IC)は変わらないのに、戦略のシャープレシオは2倍以上になった。この食い違いには、2つの説明がありうる。
1つは、ファクターが予測全体の当たり具合ではなく、両端の当たり具合を良くしたという説明だ。ロングショート戦略は予測値の上位と下位だけを使うので、真ん中の銘柄の予測が外れていても成績には響かない。平均ICがほぼ同じでも、「大きく上がる」「大きく下がる」と予測した銘柄の精度が上がっていれば、戦略のリターンは良くなる。
もう1つは、ファクターが正則化(モデルが過去のデータに合わせすぎるのを抑える働き)の役割を果たしたという説明だ。予測のぶれが減れば日々の損益のぶれも減り、シャープレシオは上がる。最大ドローダウンが54.5%から28.4%に縮んだ事実は、この説明と合う。
5. 論文との比較と考察
今回の日本株の結果を、論文が報告した米国・中国の結果と並べる。論文の値は、既存の予測モデル3つ(DoubleAdapt、D-Va、Co-CPC)にファクターを足す前と後の範囲で示す。
| 市場 | IC(前 → 後) | ICの改善率 | シャープレシオ(前 → 後) | 改善率 |
|---|---|---|---|---|
| 米国(論文) | 0.049〜0.054 → 0.054〜0.056 | +4〜11% | 1.13〜1.37 → 1.57〜1.63 | +19〜38% |
| 中国(論文) | 0.069〜0.071 → 0.073〜0.074 | +5〜6% | 1.71〜1.92 → 2.41〜2.50 | +27〜41% |
| 日本(今回) | 0.0259 → 0.0260 | +0.4% | 1.01 → 2.34 | +132% |
ICの改善率は、日本株では+0.4%で、論文の+4〜11%にも届かない。しかもベースラインの時点で水準が違う。日本株のIC(0.026)は米国(0.05前後)の半分、中国(0.07前後)の3分の1強しかなく、価格と出来高のデータだけでは日本株の翌日の値動きをほとんど当てられていない。
シャープレシオの改善率は+132%と、論文の+19〜41%より大きい。ただし4節で見たとおり、これは両端の予測か予測のぶれが良くなったためで、ICの改善とは別の理由で起きている可能性が高い。論文でも、予測精度の改善(数%)に比べて投資成績の改善(数十%)のほうがはるかに大きく、順位の両端が当たれば戦略の成績は大きく変わると説明している。
日本株でICが改善しなかった理由
日本株でICが改善しなかった原因は、次のあたりにあると考えている。
- 業種の平均で代用したこと: 同じ業種でも銘柄ごとに動きがばらつけば、業種の平均からの乖離は「非合理なずれ」ではなく、ただの個別要因を拾ってしまう。論文のように、一緒に動く銘柄の組み合わせをデータから選ぶほうが、ずれの意味がはっきりする
- 市場参加者の違い: 中国の株式市場は売買代金の6割前後を個人投資家が占め(2022年1〜9月は61%と当局のデータで報じられている)、群集心理による行き過ぎが出やすい。日本の東証プライム市場では個人の売買代金は約27%(2025年)で、海外投資家が3分の2を占める。行き過ぎが小さければ、それをとらえるファクターが予測に足せる情報も小さくなる
- 近似計算の限界: 市場レベルの同期度を簡略化した計算で代用したため、論文と同じ精度でファクターを作れていない。全ファクターのモデルで銘柄レベルのみのモデルよりICが下がった一因は、ここにあるかもしれない
この結果の使い方
「市場の非合理性を数値にして予測に使う」という枠組みは、行動ファイナンス(投資家の心理のくせを研究する分野)の知見を予測モデルに直結させる発想で、理屈の筋は通っている。日本株での結果は「ICの改善なし」「コスト後はマイナス」で、個人投資家がそのまま使える内容ではなかった。
個人的には、日本株で先に手を付けるべきなのは、非合理性の指標を足すことより、予測の土台を引き上げることだと見ている。ベースラインのICが0.026という水準では、どんなに優れたファクターを足しても大幅な改善は望みにくい。価格と出来高に加えて、財務指標やアナリスト予想、信用残や投資主体別売買動向といった需給のデータを入力に足せば、土台のICそのものが上がる余地がある。
6. まとめ
検証の結果の受け止め方
論文の主張のうち日本株で確かめられたのは、「非合理性の指標を足すと戦略の成績が良くなる」の部分だけで、「予測精度が上がる」の部分は再現できなかった。成績が良くなった理由は、予測が当たるようになったからではなく、予測のぶれが減ったからだと見ている。そして、その良くなった成績も、取引コストを引くと残らない。日本株で使うなら、入れ替えの頻度を落としてコストを減らすことと、ベースラインの予測力を上げることが先で、非合理性の指標はその後に足す道具になる。
次に試すこと
今回は論文の再現を優先したので、改善の余地は多い。順番に試すなら次のとおりだ。
- 入れ替えの頻度を落とす: 日次ではなく週次・月次の入れ替えにして、取引コストを10分の1以下に抑える
- 入力を増やす: 価格と出来高に財務データや需給データを足し、ベースラインのICを引き上げる
- 市場レベルのファクターを論文どおりに作る: 近似で精度が落ちた影響を取り除く
- 業種ごとに効果を分ける: どの業種で非合理性ファクターの予測力が高いかを調べ、その業種に絞って使う
論文の手法をそのまま日本株に当てはめて、そのまま利益になることはまずない。それでも、論文の考え方を出発点に日本市場の性質に合わせて作り替える価値はある。まずは上の4つを順に試す。
※本記事は公開情報に基づく情報整理であり、個人の見解を含みます。特定の銘柄の売買や投資を推奨するものではありません。投資判断はご自身の責任においてお願いいたします。